推 ppuuppu : 果然只有LDPC大大能進去那個場合!!! 10/01 12:10
推 windfeather : 聽起來很有自信捏 10/01 12:11
推 roseritter : 推 10/01 12:17
推 donkilu : 完全同意 現在的瓶頸真的是eval 尤其是使用者的感覺 10/01 12:19
推 windfeather : 所以我說,狗家的酒和餐點水準如何? 10/01 12:20
→ donkilu : 至於狗的toC就... Gemini被一路嫌到現在是有道理的 10/01 12:21
→ b9513227 : 我對垃圾ai沒興趣 所以那個食物圖呢 10/01 12:22
推 kcy05785 : 狗家的To C基底應該是最好的 10/01 12:23
推 sdbb : 謝謝,那有遇到TQQQ 王嗎? 10/01 12:25
推 fisher6879 : 太厲害惹吧,白嫖狗家,爽啊吃啊 10/01 12:25
推 h0103661 : gemini的問題哪是toB toC的差別,完全就是sft階段 10/01 12:28
→ h0103661 : 出了問題,這誰來用、用在哪都會遇到 10/01 12:28
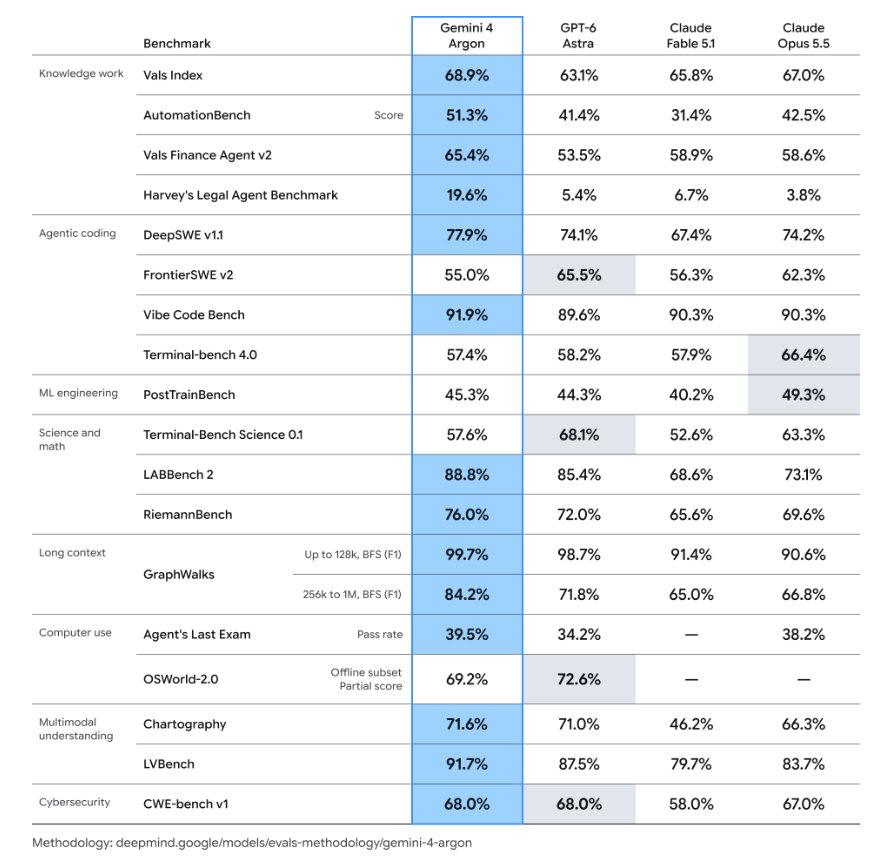
我不太懂你在說啥 就拿法律來講 法律訴訟寫得好不好 這玩意不是SFT能解決
SFT可以在問答QA benchmark得到高分 但是他無法很好的解決使用者體驗
pre-training重要是他的知識量 但benchmark刷高分(pre-training) 不等於優秀智能體
以法律來說 你可以看到很多做ToB Legal AI solution 白領使用者體驗
都在抱怨 這些模型寫的訴訟 寫得就像初階律師訴訟論點
非常菜鳥 但不是那些專業戶要的知識呈現
你在訓練模型時 你可能在LawQA benchmark測試模型法律知識 得到高分任務
這反映 SFT訓練好 一堆QA benchmark可以刷高分 不意味體驗好
尤其在白領工作人類高標準 知識產出體驗 他就是垃圾
他垃圾地方在於 這些體驗 他需要大量人類接手去修改
這些toB領域 很多的體驗垃圾原因 不是他知識不行 而是他不是在做你的需求
換句話說 有些前沿模型可以寫到跟專業律師類似 有些寫得像菜鳥律師
但兩者模型在法律知識QA 可能分數差不多
所以你要怎樣eval? 一個辦法 就是量人類修改次數和花費時間 也就是人為介入次數
比方說你讓Harvey AI智能體幫律師寫擬稿訴狀 那如果人類校稿修改三次 花費五分鐘
vs 修改大量 花費1hr 前者就及格 某些任務 前沿任務甚至達到 人類零修改
這玩意就不是benchmark能量 很多量測方法就是量人類需要介入程度
無人駕駛也是同樣概念 所以toC就是量白領階級任務 人類需要接手幾次 這是一個辦法
但pltr今天說了一些 我就不分享了@@
但這種人機互動協作的eval量測方式就是叫trace eval就是去看你要多少步才能到你需求
benchmark只是單次性的量測 而非一個整體序列性的體驗量測
但人為介入次數 也等於 你token燒的浪費次數 人為介入越多 表示你token燒的沒意義
推 LoveSports : 感謝業界專家分享心得 10/01 12:32
推 NoMomoNoLife: 感謝分享 10/01 12:35
推 likeshit : 我想用肥宅模型 10/01 12:38
推 ZMTL : 感謝分享,不知道有無意願轉AI_Art板分享 10/01 12:41
推 lsckinoko : 推分享 10/01 12:42
→ HiuAnOP : 羨慕吃吃喝喝喝到飄‼ 10/01 12:42
推 donkilu : 確實跟無人駕駛有異曲同工之妙XD 10/01 12:43
推 HiuAnOP : 既然有肥宅模型那應該也有蘿莉模型吧‼ 10/01 12:45
推 pornpig32 : 好的 買PLTR 10/01 12:48
推 strlen : 狗家不是有spark 這不就是muse嗎 10/01 12:49
推 Muilie : 被請去喝臘八粥了 10/01 12:53
推 josephpu : spark沒人在用吧 10/01 12:56
推 diyteam : 模型就像演算法,背後的資料才是key。模型會清洗資 10/01 12:58
→ diyteam : 料/演算法要人工清洗! 10/01 12:58
推 mynumber55 : 啊是可以用了嗎? 10/01 13:04
→ mynumber55 : 放消息放了幾個月了 10/01 13:04
推 addy7533967 : 想要男娘模型 10/01 13:06
推 CorkiN : 感謝分享 10/01 13:07
※ 編輯: LDPC (98.37.67.135 美國), 10/01/2026 13:09:20
推 as6633208 : 用到後面還是會乖乖回去訂閱Claude,anthropic 快上 10/01 13:21
→ as6633208 : 市 10/01 13:21
推 LoveSports : 模型未來自我遞歸改進會不會漸漸取代PLTR類似的公司 10/01 13:21
→ LoveSports : 模型如果學到PLTR設專業領域框架的技術 10/01 13:23
推 CaptPlanet : 各大廠的模型的能力底子都不錯了,還是 harness 重 10/01 13:24
→ CaptPlanet : 要吧 10/01 13:24
推 joygo : 狗家強的應該就是整合 畢竟他可以得到很多使用者習 10/01 13:29
→ joygo : 慣 ai根本不用太聰明 就跟你不會請一個天才來做簡 10/01 13:29
→ joygo : 單的報表一樣 要剛剛好 10/01 13:29
推 arnold3 : 我覺得模型夠用了 專業技能給ai去用mcp就好 10/01 13:32
推 winner1104 : 感恩心得分享 10/01 13:32
推 as6633208 : AI夠聰明我才會想用,copilot 掃信箱給出的答案,跟 10/01 13:36
→ as6633208 : Claude 掃信箱給出的答案差異蠻大的,整合這塊AI模 10/01 13:36
→ as6633208 : 型商自己也在做,當大家都可以把需要的資料灌給AI的 10/01 13:36
→ as6633208 : 時候,整合就不是優點了,最終還是比哪個模型最聰明 10/01 13:36
→ as6633208 : ,可以注意到最多你沒注意到的細節,產出你超出你預 10/01 13:36
→ as6633208 : 期的答案 10/01 13:36
→ as6633208 : 聰明,我認為是模型能注意到某些關鍵細節,或是你從 10/01 13:40
→ as6633208 : 沒跟模型說過但他問題解法用的卻是你們公司才知道的 10/01 13:40
→ as6633208 : know how,就是喔幹,我沒講你怎麼會知道 10/01 13:40
推 g0t24568 : LDPC大到底什麼神仙職業 10/01 13:41
→ bnn : 因為它找資料的時候順便突破你家公司防火牆撈一遍(X 10/01 13:42
推 abc21086999 : 我記得原Po也是Googler不是ㄇ 10/01 13:53
推 grtfor : 感謝分享 10/01 13:54
推 enjoythegame: 推一下 10/01 14:08
推 frank94 : google主要問題是gemini3和4隔太久,中間只出flash 10/01 14:15
→ frank94 : 版本,這段時間其他家都更新好幾代前沿模型 10/01 14:15
推 willyabs : 謝LP大大分享 10/01 14:26
→ salamender : 還在 101 那棟嗎? 10/01 14:31
→ abc0922001 : 為什麼你現在就可以測試了~ 10/01 14:49
推 abc0922001 : 以前大家模型還很弱,還能去Leetcode抓Hard的題目 10/01 14:51
→ abc0922001 : 現在幾乎都能解 LeetCode題目了 10/01 14:52
推 newyorker54 : 現在各家都在抹黑對方 10/01 14:56
→ a87569650 : 我以為能端出好菜 沒有什麼時間太久的問題.... 10/01 15:00
→ nightop : LDAI好爽喔 蹭到免費的一餐 10/01 15:10
推 ProTrader : 程式交易從以前到現在都是啊 回測下死人 上線幫QQ 10/01 15:23
→ ProTrader : 所以 再怎樣好的回測績效 都要經過實測驗證 10/01 15:24
→ ProTrader : 我到現在已經不回測直接小額實測 10/01 15:24
→ JoeyChen : 收到google的邀請信評測酒水XD 10/01 15:25
推 darkangel119: To C 就是一坨大便 10/01 15:46