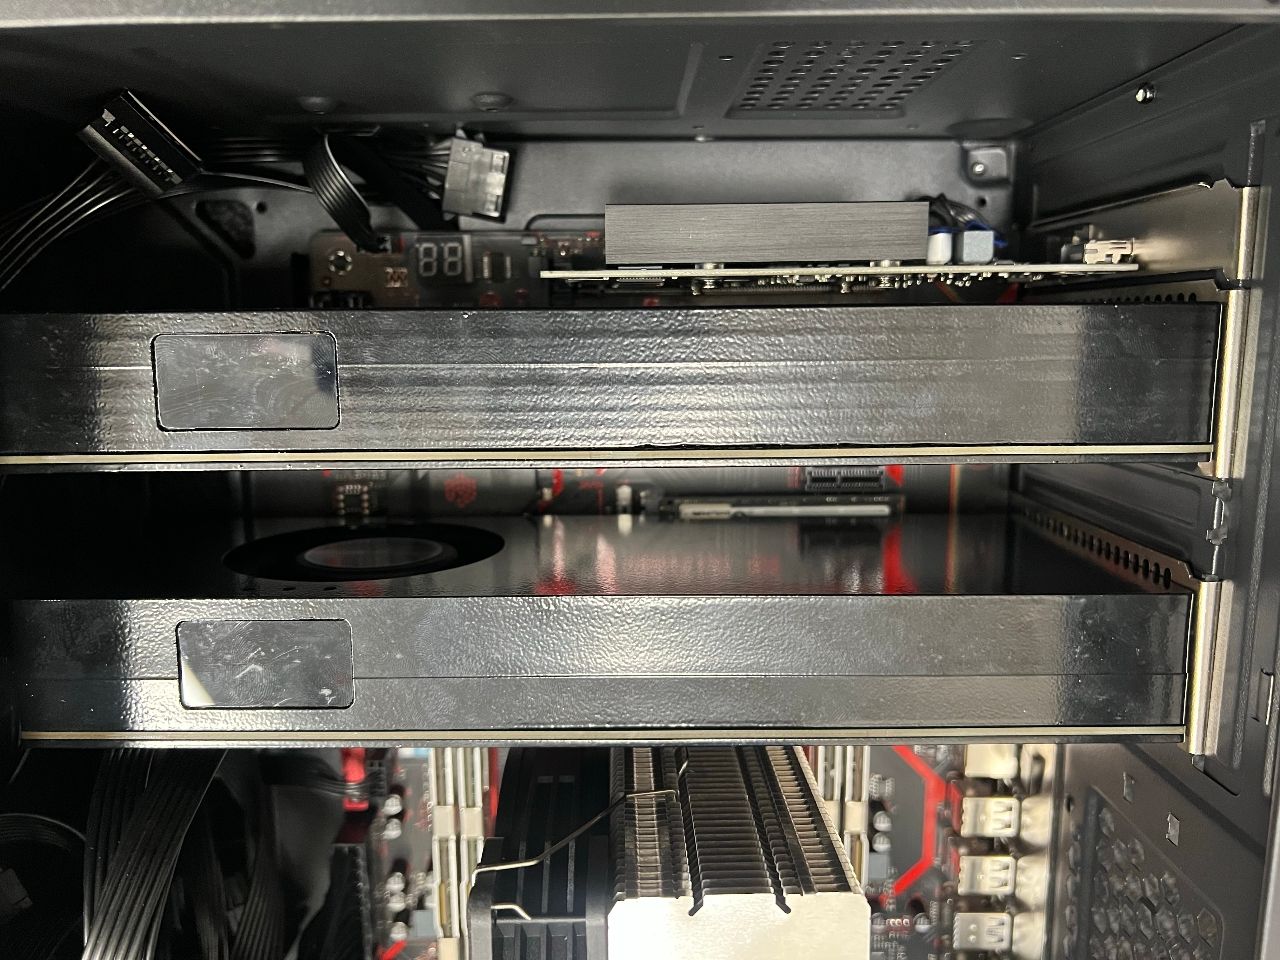
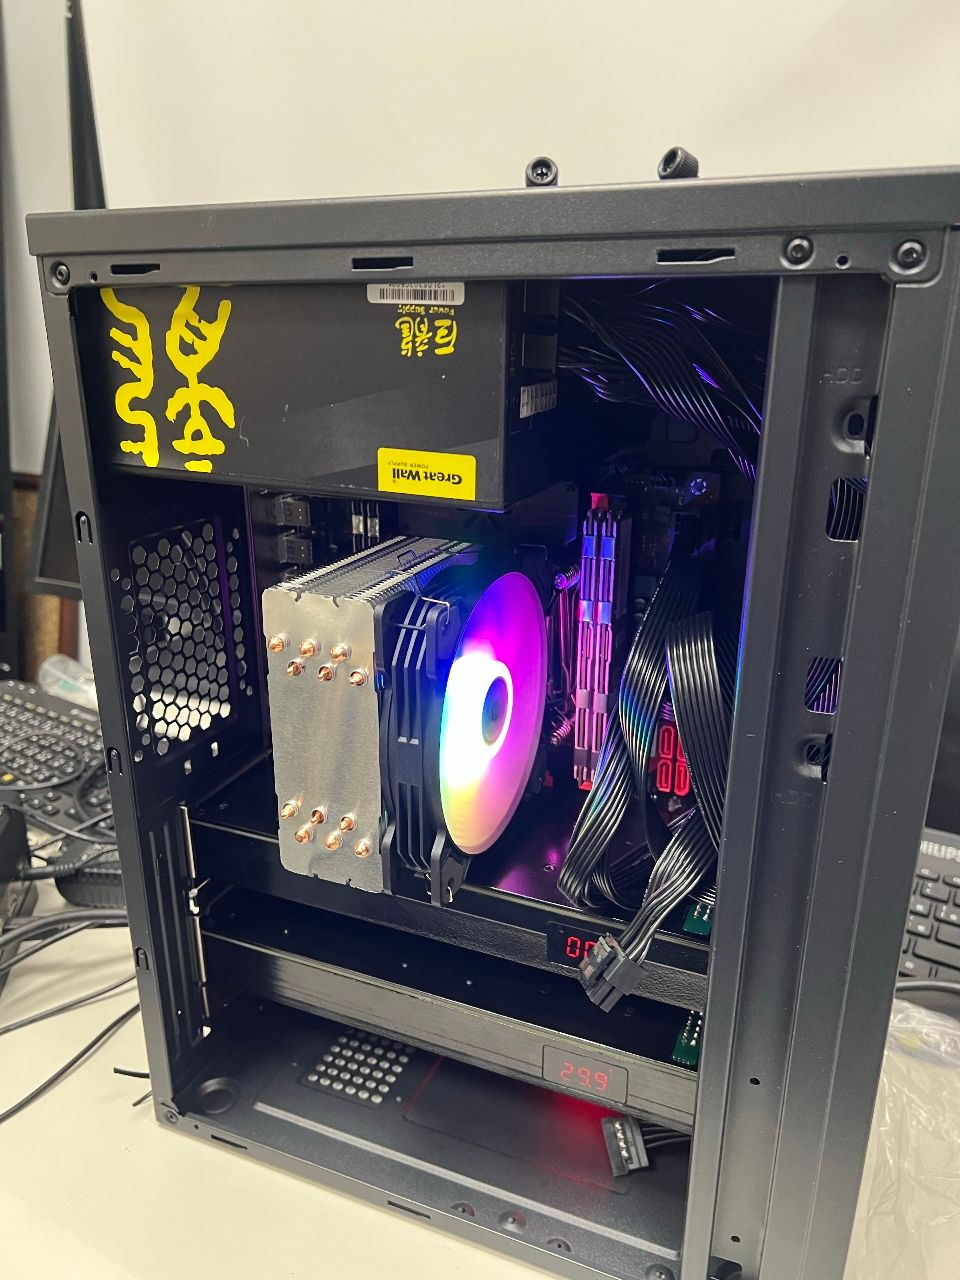
噓 ginlom: 卡一個220.133.150.159 10/23 16:35
※ 編輯: are2 (118.150.170.141 臺灣), 10/23/2026 16:43:22

→ shinjikawuru: 我垃圾中的戰鬥機 2080TI 22GB魔改122.121.165.237 10/23 16:50
→ are2: 樓上你PP輸我呀118.150.170.141 10/23 16:57
→ are2: 跑agent應用 pp比tg重要得多吧118.150.170.141 10/23 17:00
推 World5566: 好潮36.231.131.30 10/23 17:00
推 Boston: CP 好高!187.15.122.14 10/23 17:43

推 crystal0504: 整套洋垃圾比5060ti 16g還便宜42.75.202.122 10/23 17:44
→ crystal0504: tolen70up 就很好用了42.75.202.122 10/23 17:44
→ narukaza: 好奇問一下,現在很流行的大逆向時代可114.34.174.204 10/23 17:59
→ narukaza: 以用本地部署AI跑嗎?114.34.174.204 10/23 17:59
推 crazyman7011: 5070ti profile 3300203.69.36.212 10/23 18:01
→ crazyman7011: 你這套勝在超值,怕MoE以後vram要求203.69.36.212 10/23 18:03
→ crazyman7011: 變高203.69.36.212 10/23 18:03
推 shinjikawuru: 雙2080一卡strata一卡comfyui 爽der122.121.165.237 10/23 18:03
→ iceyang: V100鹹魚大翻身114.38.96.84 10/23 18:07
推 Chilloutt: 太強惹1.164.202.238 10/23 18:40
→ are2: 買HBM2比DDR5便宜 跑LLM儍子才去買新的118.150.170.141 10/23 18:56
推 d030b: 感謝分享 104.28.223.57 10/23 19:09
→ spfy: 太便宜了吧 27.51.24.218 10/23 19:13
推 newyorker54: 跑生圖跑LLM 真的用ddr3,ddr4最好 36.237.175.21 10/23 19:13
→ newyorker54: vram, dram夠大才是王道,如果V100 X 36.237.175.21 10/23 19:14
→ newyorker54: 4應該速度可以再拉高一倍 36.237.175.21 10/23 19:14
推 kunyi: 便宜推一個 59.124.80.190 10/23 19:59
推 jen1121: 推 36.224.182.14 10/23 20:06
→ gbcg9725: 逆向目前還是適合閉源模型跑吧 103.1.245.36 10/23 20:44
→ spfy: 逆向要夠強的computer use和模型能力 難吧223.137.241.93 10/23 20:51
推 selvester: 好心動 幹 39.10.33.191 10/23 21:01
推 tennyleaz: 有垃圾有推116.241.18.17 10/23 21:18
推 pxhome: 好奇問,為何V100沒有NVLink?36.230.157.132 10/23 21:29
→ are2: 有NVLink但我用PCIE X16 pp已經1.6倍了118.150.170.141 10/23 21:31
→ are2: 用Nvlink要專用板子不便宜 那CP值就低了不少118.150.170.141 10/23 21:32
推 Sighman: 可惡想買220.132.241.14 10/23 21:36
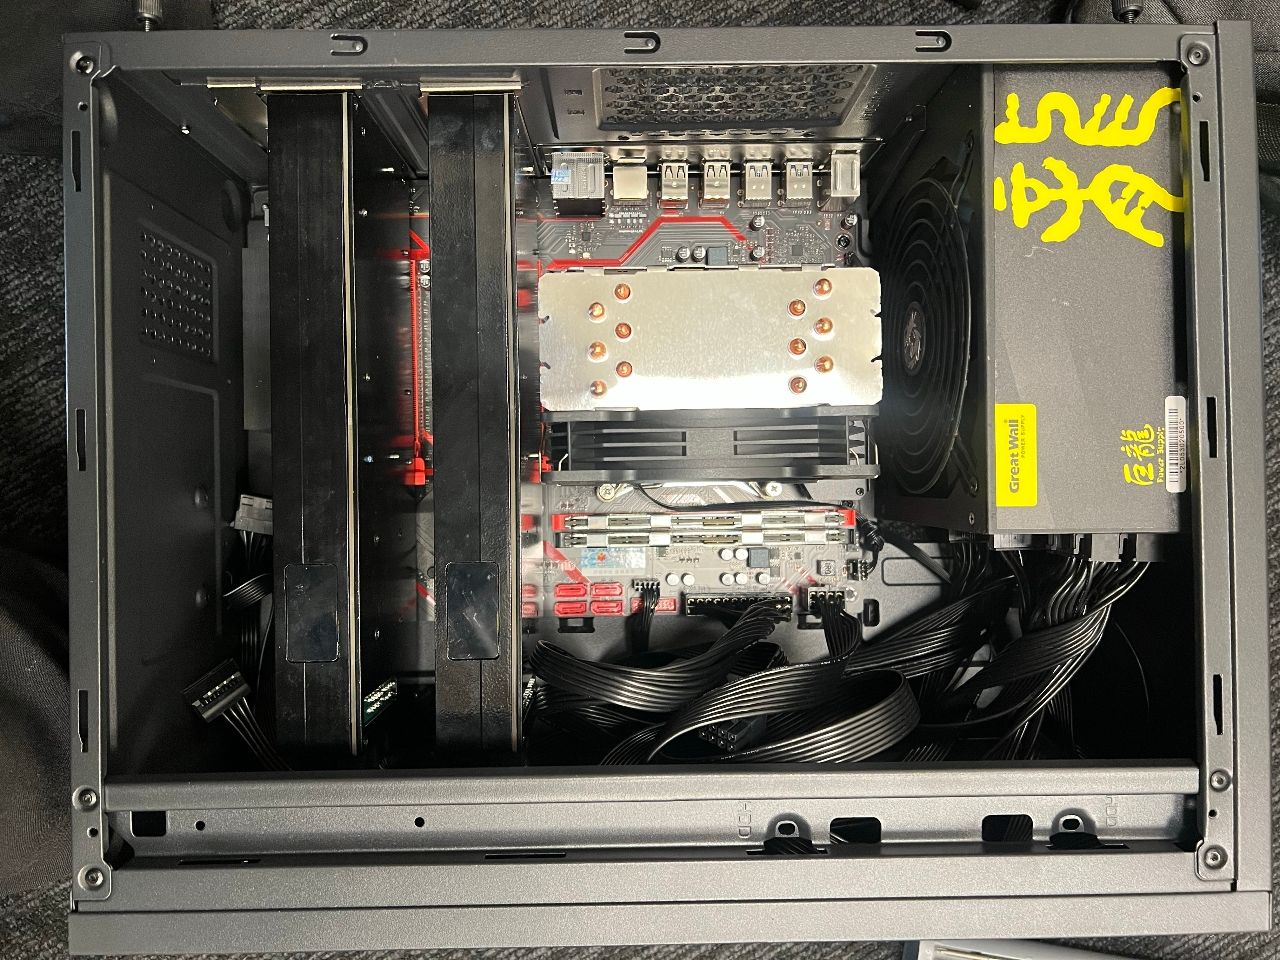
推 a1379: X299該不會要復活了 四通道128GB+44條PCIE 42.73.11.217 10/23 21:43
→ w1222067: 不錯,有想法,有夠便宜 61.224.6.22 10/23 21:56
推 reaturn: 成本問題220.143.95.188 10/23 22:09
推 GenShoku: 本地逆向deepseek跟glm跑的起來,不如說 123.192.94.227 10/23 22:50
→ GenShoku: 有些claude跟gpt拒絕的就是靠這倆的破限123.192.94.227 10/23 22:50
→ GenShoku: 版跑的,qwen strata暫時還沒看到實際案123.192.94.227 10/23 22:50
→ GenShoku: 例,但簡單的應該也能跑 123.192.94.227 10/23 22:50
推 GenShoku: 另外是與其說agent應用prefill速度重要123.192.94.227 10/23 22:59
→ GenShoku: ,不如說是strata架構存在跨會話KV cach123.192.94.227 10/23 22:59
→ GenShoku: e調用跟緩存命中偏低的問題,所以prefil123.192.94.227 10/23 22:59
→ GenShoku: l才很重要,不然一般使用來說decode速度123.192.94.227 10/23 22:59
→ GenShoku: 還是重要 123.192.94.227 10/23 22:59
→ are2: 樓上不是這樣 agent很常去讀陌生代碼跟文件118.150.170.141 10/23 23:10
→ are2: 那都沒得快取到118.150.170.141 10/23 23:10
→ are2: 去分析自己雲端帳單也能看出輸入遠高於輸出118.150.170.141 10/23 23:12
→ WTS2accuracy: kv cache跟一般軟工的cache不同... 101.14.11.230 10/23 23:21
→ WTS2accuracy: 跟讀的東西陌不陌生沒關係的101.14.11.230 10/23 23:22
→ WTS2accuracy: 至於kv cache是啥架構能找AI科普101.14.11.230 10/23 23:22
→ are2: 我說的就是prompt cache 目前最好的就是SGLa118.150.170.141 10/23 23:32
→ are2: ng 但他也是token前綴不對就prefill118.150.170.141 10/23 23:32
→ are2: radix tree都要計較prefill速度了 還真以為118.150.170.141 10/23 23:32
→ are2: 用不到?118.150.170.141 10/23 23:32
→ are2: 不然decode速度很單純沒啥好比的呀 就頻寬跟118.150.170.141 10/23 23:34
→ are2: mtp接受率而已118.150.170.141 10/23 23:34
推 doudoulon: 很棒的想法ㄟ~~但有個問題 59.127.61.154 10/23 23:44
→ doudoulon: NVIDIA新版的CUDA 13已經不支援V100了 59.127.61.154 10/23 23:45
→ doudoulon: 驅動580也是最後一版了 之後STRATA如果 59.127.61.154 10/23 23:46
→ doudoulon: 升級要求新版 你這台就跟不上了 59.127.61.154 10/23 23:46
cuda不支援沒關係,關鍵都是怎麼把量化反解到FP16,像我就搞NVFP4並實測成功(https
://lcz.me/post/26895)
現在有AI幫忙弄 Cuda護城河隨時都能挑戰,你隨時都能客製自己的推論引擎
推 shinjikawuru: prefill當然也重要阿1.5K我就滿意了122.121.165.237 10/23 23:55

推 WJAider: CP 大師你好,請收下小弟膝蓋 OTL 114.36.79.25 10/23 23:56
→ shinjikawuru: 之前那個27B 才500 現在strata爽~122.121.165.237 10/23 23:57
推 FreedomTrail: 羨慕,5080組起來比你的貴多,還只 180.218.85.70 10/24 00:03
→ FreedomTrail: 能跑小模型QQ 180.218.85.70 10/24 00:03
※ 編輯: are2 (118.150.170.141 臺灣), 10/24/2026 00:06:34
→ are2: prefill 1.5k以上真的是舒服門崁118.150.170.141 10/24 00:07
推 shinjikawuru: 5080才令人羨慕 strata comfy都超快122.121.165.237 10/24 00:09
→ are2: 我過幾天來裝steam docker實測V100遊戲性能118.150.170.141 10/24 00:14
→ Rust: 怎麼不用 IQ4 123.241.91.165 10/24 00:17
→ are2: 樓上 我昨天已做完NVFP4相容了 現在爽用118.150.170.141 10/24 00:18
→ ntuarthur: 最近剛下單 V100 32GB,洋圾垃真香。 140.138.85.68 10/24 01:02
推 ack0011: 我之前急了收的7900XTX跟這比起來真的超 49.217.124.164 10/24 01:09
→ ack0011: 盤,單卡的價格跟這整台一樣,算力低VRAM 49.217.124.164 10/24 01:09
→ ack0011: 沒有比較多還沒有CUDA 49.217.124.164 10/24 01:09
→ are2: 樓上RDNA3如果有釋放還蠻強的 要調hipBlastW118.150.170.141 10/24 01:39
→ are2: 跟運用WMMA矩陣器強很多 生態會愈來愈好118.150.170.141 10/24 01:40
→ are2: 我用395跑qfn 都能噴到pp1800 tg50-70了 790118.150.170.141 10/24 01:44
→ are2: 0XTX調好只會更強118.150.170.141 10/24 01:44
推 samsonfu: 卡49.216.107.228 10/24 02:26
→ narukaza: V100 32G價格快16G的三倍,感覺不划算, 114.34.174.204 10/24 02:38
→ narukaza: 不過VRAM的確是越大越好啦,然後上面都 114.34.174.204 10/24 02:38
→ narukaza: 要用DDR4了,現在怎麼可能還選X299,當 114.34.174.204 10/24 02:38
→ narukaza: 然是直上EPYC 8通道DDR4+128條PCI-E lan 114.34.174.204 10/24 02:38
→ narukaza: es隨便你用 114.34.174.204 10/24 02:38
我建議別這樣搞 DDR4現在也貴 EPYC板貴
先說我當初主板沒挑好亂買到雙通道DDR3
以為完蛋了 要退板子嗎?
實測真的還好 畢竟熱專家丟VRAM去命中
所以這測試數據都是ddr3 1866雙通道
Strata不是高併發引擎 搞再強也開不了太多對話
沒必要為這玩意兒花大錢
就是搞台性價甜密點主機在家當LLM edge server
→ narukaza: 另外我還有一個疑問,現在本地AI多卡協114.34.174.204 10/24 02:38
→ narukaza: 作一定要同家卡嗎?還是可以A+N+I混合?114.34.174.204 10/24 02:38
都要同一家 但能跨世代架構
※ 編輯: are2 (118.150.170.141 臺灣), 10/24/2026 03:38:39

→ shinjikawuru: 雙卡測試 預填1900! 今天更新有感122.121.165.237 10/24 04:17
推 widec: cool 36.233.227.173 10/24 08:04
推 visa829: 我買的洋垃圾也在路上了,經過搶DDR4,5後 220.134.49.176 10/24 08:11
→ visa829: 也是發現X99+DDR3太香了... 220.134.49.176 10/24 08:12
推 mightysuns: cp值爆錶 36.226.67.109 10/24 08:35
推 jojo396: 買這種每次用不到一兩年就出問題,當消耗 101.10.84.212 10/24 09:52
→ jojo396: 品用,還好都賣掉了 101.10.84.212 10/24 09:52
推 exile9340: 不懂問一下這個跑comfy生圖也很快麼? 122.118.2.116 10/24 09:55